

queryKey 是快取的鑰匙,但我當時沒讀原始碼。它到底是怎麼比較兩把 key 的?
useMemo,什麼時候這個最佳化反而把事情搞更複雜」。那個界線在哪?能不能量出來?
useMemo 的三大用途了,今天還能講出什麼新東西?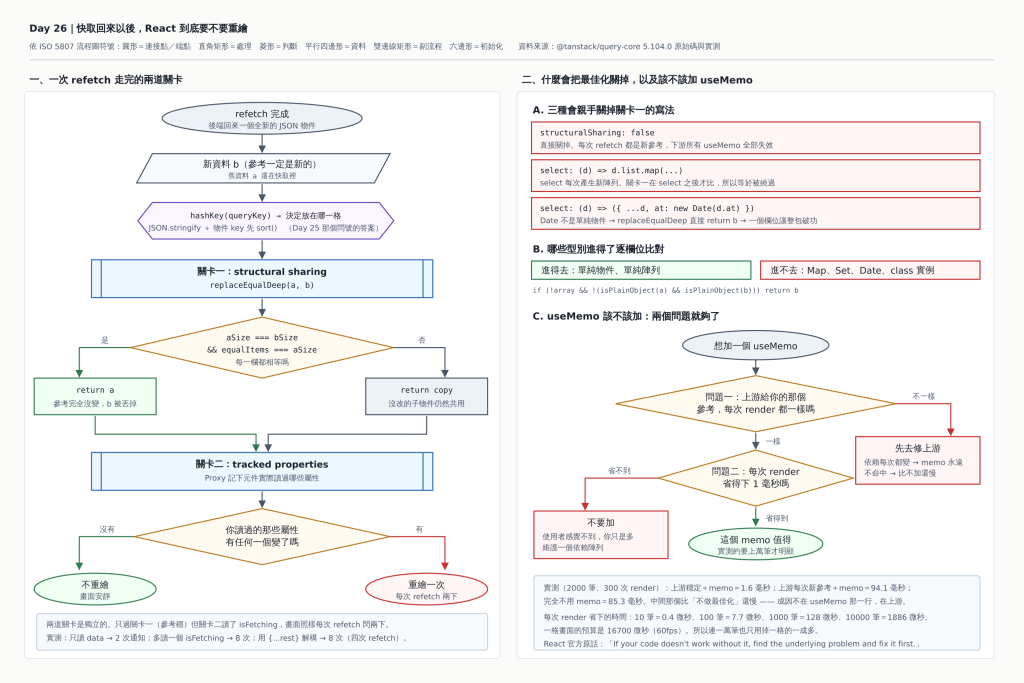
Day 25 的「沒有驗證的部分」我留了一句話:
TanStack Query 內部到底怎麼比較 queryKey 我沒有讀原始碼,但從實測行為推斷應該是深度比較或序列化比較,具體細節在
packages/query-core/src/utils.ts裡。
今天讀了。答案是序列化比較,而且序列化之前會先把物件的 key 排序。函式叫 hashKey:
export function hashKey(queryKey) {
  return JSON.stringify(queryKey, (_, val) =>
    isPlainObject(val)
      ? Object.keys(val)
          .sort()
          .reduce((result, key) => {
            result[key] = val[key]
            return result
          }, {})
      : val,
  )
}
白話解釋這段:它就是 JSON.stringify,但塞了一個 replacer。 replacer 每遇到一個「單純物件」就先用 Object.keys(val).sort() 把 key 排好、重組成一個新物件再序列化,所以 { a, b } 與 { b, a } 會產生同一個字串。
實測(@tanstack/query-core 5.104.0,直接呼叫它公開匯出的 hashKey):
  hashKey(['stats', { status, page }]) = ["stats",{"page":1,"status":"done"}]
  hashKey(['stats', { page, status }]) = ["stats",{"page":1,"status":"done"}]
  相同嗎:是
所以 Day 25 的推斷方向是對的,但「深度比較」那半是錯的——它不做結構走訪比對,它把整把 key 壓成一個字串當 Map 的 key 用。
這個實作細節會直接生出兩個很難 debug 的陷阱。
1 與字串 "1" 是兩把不同的 key hashKey(['stats', 1]) = ["stats",1]
hashKey(['stats', '1']) = ["stats","1"]
相同嗎:否
這條最容易踩,因為網址參數(useParams、query string)拿到的永遠是字串,而你自己寫死的測試資料常常是數字。同一筆資料會被存成兩份快取,invalidateQueries 打到其中一把,另一把不會動——這正好是 Day 25 那個「統計卡片不更新」的另一個成因。
undefined 的欄位會整個消失 hashKey(['stats', { eventStatus: undefined, page: 1 }]) = ["stats",{"page":1}]
hashKey(['stats', { page: 1 }]) = ["stats",{"page":1}]
相同嗎:是
因為 JSON.stringify 會丟掉值為 undefined 的屬性。所以「篩選器被清空」與「根本沒有這個篩選器」會落在同一個快取格子裡。
這通常剛好是你想要的行為,但它是巧合不是設計。如果你希望兩者是不同的快取,要自己把它寫成 null 或字串。
invalidateQueries 的前綴比對規則Day 25 的「模式三:分層 key 設計」靠的是另一個函式 partialMatchKey。它把你傳進去的 key 當樣板,逐項比對快取那把 key 的開頭:
| 快取裡的 queryKey | 傳給 invalidateQueries 的 key |
命中 | 說明 |
|---|---|---|---|
["stats","list",{"page":1}] |
["stats"] |
是 | 失效整個 stats 家族 |
["stats","list",{"page":1}] |
["stats","list"] |
是 | 只失效列表 |
["stats"] |
["stats","list"] |
否 | 樣板比快取的 key 更長 |
["stats",{"page":1,"q":2}] |
["stats",{"page":1}] |
是 | 物件只比對樣板列出的欄位 |
["stats",{"page":1}] |
["stats",{"page":2}] |
否 | 欄位值不同 |
注意第四列:物件是「部分比對」,樣板沒寫到的欄位根本不會被檢查。 所以 ["stats", { page: 1 }] 會一併失效掉「page 是 1 但其他條件各異」的所有快取。方便,但也代表你很容易 invalidate 到比預期多很多的東西。
replaceEqualDeep現在進第二個問題。官方文件對 structural sharing 的說明只有兩句:
React Query will keep the original reference if nothing changed in the data.
If a subset changed, React Query will keep the unchanged parts and only replace the changed parts.
那兩句話的實作是 replaceEqualDeep。它的最後一行是整段的靈魂:
return aSize === bSize && equalItems === aSize ? a : copy
白話解釋這行:如果新舊資料的欄位數一樣,而且每一欄都判定相等,就回傳舊的那個 a,新拿到的 b 直接丟掉。 否則回傳一個新物件 copy,但 copy 裡面沒變的那些子物件,塞的仍然是 a 的子物件(同一個參考)。
  舊 === 新(兩個不同的物件):否
  replaceEqualDeep(舊, 新) === 舊:是   ← 這就是「保住參考」
  replaceEqualDeep(舊, 新) === 新:否   ← 新的那份被丟掉了
這一行為什麼重要:React 判斷要不要重繪用的是 Object.is 比參考(Day 23 拆響應式三零件時講過,React 沒有攔截層,只能比參考)。參考沒變,React 就有機會跳過。
所以「後端回來一樣的資料」在 TanStack Query 裡是真的不會產生新參考,不是靠你自己寫 useMemo 去補救。
  整體同參考:否   ← 因為 sold 真的變了,外層必須換新
  結果2.list === 舊.list:是   ← 沒改的部分重用
  結果2.meta === 舊.meta:是   ← 沒改的部分重用
所以掛在 list 上面的那個 useMemo(排序、分組)不會因為 sold 變了而重算。這是 structural sharing 真正幫你省下來的東西,而且它省的不是它自己的時間,是你下游所有 memo 的時間。
replaceEqualDeep 裡有一行守門員:
const array = isPlainArray(a) && isPlainArray(b)
if (!array && !(isPlainObject(a) && isPlainObject(b))) return b
白話解釋這行:只有「單純陣列」與「單純物件」會進去逐欄位比對,其他東西一律 return b——直接換成新的那份,不做任何重用。這就是官方說的「只適用於 JSON 相容的資料」在原始碼裡的樣子。
實測六種型別,內容都一樣:
| 型別 | 內容相同時能重用舊參考嗎 |
|---|---|
| 單純物件 | 是 |
| 單純陣列 | 是 |
Map |
否 |
Set |
否 |
Date |
否 |
| class 實例 | 否 |
Date 欄位讓整包破功 const a = { sold: 1, updatedAt: new Date('2026-01-01') }
const b = { sold: 1, updatedAt: new Date('2026-01-01') }
整體重用:否
updatedAt 重用:否
理由回到第二節那一行:equalItems 少算一個,equalItems === aSize 就不成立,所以回傳 copy 而不是 a。
什麼時候會發生:後端回傳的 JSON 裡 updatedAt 是字串,所以原本沒事。但只要你在 select 裡寫 new Date(row.updatedAt) 把它轉成 Date,structural sharing 就從那一刻開始對這包資料完全失效。同理:在 select 裡 new Map(...)、包成 class 實例、或換成 Immutable.js 的結構。
這是一個很典型的「好意造成的效能問題」:你只是想讓下游拿到好用的型別,結果把整個最佳化關掉了。
這一節是我今天最想寫的,因為它是我自己原本也搞混的地方。
我原本以為 structural sharing 就等於「不重繪」。實測之後發現不是。
用真實的 QueryObserver 量(不是模擬):同一個 query 連續 refetch 四次,後端每次都回完全相同的資料,理想狀況畫面一次都不該更新。
| 元件怎麼用 useQuery 的回傳值                   | 四次 refetch 的通知次數 |
|---|---|
| const { data } = useQuery(...)                |  2 |
| const { data, isFetching } = useQuery(...)    |  8 |
| const { ...rest } = useQuery(...)             |  8 |
只讀 data 是 2 次(初次 pending、初次拿到資料),之後完全安靜——因為 data 的參考被 replaceEqualDeep 保住了。
但只要多讀一個 isFetching,就變成 8 次,也就是每次 refetch 的開始與結束各通知一次。那個「載入中的小轉圈」就是這麼來的,而它的代價是整個元件每次 refetch 重繪兩遍。
第三列官方文件有明確警告:
If you use object rest destructuring, you will disable this optimization.
因為 rest 解構會把每一個屬性都讀一遍,等於訂閱了全部。這個機制叫 tracked properties,官方原話是:
React Query will only trigger a re-render if one of the properties returned from
useQueryis actually "used".
它是用 JavaScript 的 Proxy 做的——這正好是 Day 23 那張「攔截、收集、觸發」三零件表裡的「攔截」,只是攔的不是你的 state,是 useQuery 的回傳值。
| 設定                              | 四次 refetch 的通知次數 |
|---|---|
| 什麼都不設(沒有 Proxy 追蹤)        | 8 |
| notifyOnChangeProps: ['data']     | 1 |
| notifyOnChangeProps: 'all'        | 8 |
| structuralSharing: false          | 8 |
| select: d => d.list.map(...)      | 8 |
這張表要老實講一件事,不然會被誤讀:這裡量的是 observer 的通知次數,不是 React 的 render 次數。純 query-core 沒有 React adapter,所以沒有自動的 Proxy 追蹤,預設就是「什麼都通知」。在 React 裡你不需要手寫 notifyOnChangeProps,因為 adapter 用 Proxy 幫你推斷;組一那三列我是用 observer.trackResult() 重現那個推斷。
data 的參考,它不負責「不通知」
兩件事都做對才會安靜。只做對一件,畫面照樣每次 refetch 閃兩下。
useMemo 該不該加:命中率不是你決定的第三個問題。先擺兩句 React 官方原話:
React will compare each dependency with its previous value using the
Object.iscomparison.
You should only rely on
useMemoas a performance optimization. If your code doesn't work without it, find the underlying problem and fix it first.
把這兩句跟第二節接起來就是今天的主結論:
useMemo的依賴比較用的是Object.is比參考,而那個參考穩不穩,是上游決定的——上游就是 TanStack Query 的 structural sharing,或你自己寫的select。所以「該不該加
useMemo」這個問題,有一半根本不在useMemo這一行。
useMemo,上游不同,結果相反資料 2000 筆,模擬 300 次 render,衍生計算是「排序 + 分組 + 加總」:
| 情況 | 總耗時(毫秒) | memo 命中 | memo 未命中 |
|---|---|---|---|
a. 上游參考穩定 + useMemo |
1.6 | 299 | 1 |
b. 上游每次新參考 + useMemo |
94.1 | 0 | 300 |
c. 完全不用 useMemo |
85.3 | — | — |
b 比 c 還慢(94.1 對 85.3 毫秒)。它每次都重算,外加一次依賴比較與一次複製。這就是 Day 25 預告裡問的「什麼時候這個最佳化反而把事情搞更複雜」的量化版本——答案是:上游參考不穩的時候,useMemo 是純成本。
而且請注意 b 的成因不在 useMemo 那一行。在真實專案裡,b 的成因是 structuralSharing: false、或 select 每次 map 出新陣列、或第三節那個 Date 雷。你去調 useMemo 永遠調不好,因為問題在上面。
固定上游穩定,只改資料量:
| 資料筆數 | 不用 memo(毫秒) | 用 memo 且命中(毫秒) | 每次 render 省下 |
|---|---|---|---|
| 1 | 0.02 | 0.05 | −0.1 微秒 |
| 10 | 0.16 | 0.04 | 0.4 微秒 |
| 100 | 2.40 | 0.08 | 7.7 微秒 |
| 1000 | 38.51 | 0.18 | 128 微秒 |
| 10000 | 567.58 | 1.69 | 1886 微秒 |
讀法是看最後一欄,然後拿它跟一格畫面的預算比:60fps 是 16700 微秒。
所以誠實的結論是:連一萬筆資料的排序分組,加上 useMemo 也只省下一格畫面的一成多。 大部分專案裡的 useMemo 對使用者是沒有感覺的,你只是多維護了一個依賴陣列。
這不是說 useMemo 沒用。它有用的場合很明確:資料量大、計算真的重、而且上游參考穩定。 三個條件要同時成立。
Day 16 講的是 useMemo 本身——三大用途、三個框架怎麼實作、三種常見錯誤。那篇的視角是「這個 API 怎麼用」。
今天的視角是上游:同一個 useMemo,上游給的參考穩不穩,決定它是最佳化還是純成本。Day 16 的「錯誤 1:依賴項是對象字面量」是這件事的一個特例(你自己在 render 裡造新物件);今天講的是你沒有自己造新物件,但函式庫幫你造了的那種情況——而那個更難發現,因為程式碼看起來完全正常。
按照「先修上游,再考慮 memo」的順序:
structuralSharing 沒被關掉(預設是開的,所以是確認有沒有人手動關)select 有沒有在製造新參考。如果 select 回傳的是 map/filter 出來的新陣列,關卡一就等於被繞過了select 裡把字串轉成 Date、Map 或 class 實例。要轉,轉在真正要用的那個元件裡,或者直接用字串比較const { ...rest } = useQuery(...)。isFetching 特別貴,因為它每次 refetch 必然變兩次useMemo。量的方法就是實測二那張表:先估資料量,再看每次 render 省下多少微秒,拿去跟 16700 比這個順序有個好處:a 到 d 都是改一行、對所有下游都生效的修法,而 e 是每個元件都要各自維護的修法。先做前者划算得多。
如果被問「你怎麼做 React 的效能最佳化」,我不會先講 useMemo,我會先講參考同一性(referential identity):
Object.is 比參考,所以所有效能討論最後都會收到「這個參考穩不穩」replaceEqualDeep 內容沒變就回傳原本那個物件,最後一行 return aSize === bSize && equalItems === aSize ? a : copy 寫得很明白Date 欄位就讓整包破功{...rest} 會把它關掉useMemo 是最後一步,而且它的命中率由上游決定。上游不穩的時候它比不加還慢,我有量過第 4、5 點是拉開差距的地方。會講 useMemo 的人很多,會講「為什麼你的 useMemo 沒有生效,而問題不在 useMemo」的人少。
檔名 day26-structural-sharing-and-memo.js。Part A 到 E 會 require('@tanstack/query-core'),沒裝也跑得起來,那幾段會自己跳過並印出提示;Part F 不需要任何依賴。要跑完整版:
npm install @tanstack/query-core@5.104.0
node day26-structural-sharing-and-memo.js
我的環境是 Node.js v22.22.2、@tanstack/query-core 5.104.0。
/**
 * day26-structural-sharing-and-memo.js
 *
 * 快取回來以後,React 到底要不要重繪
 * 從 TanStack Query 的 replaceEqualDeep 讀到 useMemo 該不該加
 * 搭配 iThome 鐵人賽 2026 Day 26
 *
 * 執行方式:node day26-structural-sharing-and-memo.js
 * 環境:Node.js v18 以上
 *
 * 依賴:Part A 到 Part E 會 require('@tanstack/query-core')
 *      沒裝也跑得起來,那幾段會自己跳過並印出提示。Part F 不需要任何依賴。
 *      要跑完整版:npm install @tanstack/query-core@5.104.0
 *
 * 六個 Part
 *   Part A  關掉 Day 25 留下的問號:queryKey 到底是怎麼比較的
 *   Part B  invalidateQueries 的前綴比對是什麼規則
 *   Part C  structural sharing 的本體:replaceEqualDeep 會回傳「原本那個物件」
 *   Part D  哪些資料型別會讓它整包破功
 *   Part E  參考穩了不等於不重繪:用真實 QueryObserver 量通知次數
 *   Part F  useMemo 的命中率由上游決定,不是由你決定
 */

'use strict'

// ------------------------------------------------------------
// 共用工具
// ------------------------------------------------------------

function 分隔線(title) {
  console.log('\n' + '='.repeat(68))
  console.log(title)
  console.log('='.repeat(68))
}

function 小標(title) {
  console.log('\n--- ' + title + ' ---')
}

const 是否 = (v) => (v ? '是' : '否')

/** 安全地載入 query-core,沒裝就回傳 null */
function 載入QueryCore() {
  try {
    return require('@tanstack/query-core')
  } catch (error) {
    return null
  }
}

const QC = 載入QueryCore()
let QC版本 = '未安裝'
if (QC) {
  try {
    QC版本 = require('@tanstack/query-core/package.json').version
  } catch (error) {
    QC版本 = '已載入但讀不到版本'
  }
}

// ============================================================
// Part A:queryKey 到底是怎麼比較的
// ============================================================

function partA() {
  分隔線('Part A:queryKey 是怎麼比較的 —— 關掉 Day 25 留下的問號')

  console.log('  Day 25 的「沒有驗證的部分」我寫了這句:')
  console.log('    「TanStack Query 內部到底怎麼比較 queryKey 我沒有讀原始碼,')
  console.log('      但從實測行為推斷應該是深度比較或序列化比較」')
  console.log('')
  console.log('  今天讀了。答案是**序列化比較**,而且序列化之前會先把物件的 key 排序。')
  console.log('  函式名字叫 hashKey,原始碼在 packages/query-core/src/utils.ts:')
  console.log('')
  console.log('    export function hashKey(queryKey) {')
  console.log('      return JSON.stringify(queryKey, (_, val) =>')
  console.log('        isPlainObject(val)')
  console.log('          ? Object.keys(val).sort().reduce((result, key) => {')
  console.log('              result[key] = val[key]')
  console.log('              return result')
  console.log('            }, {})')
  console.log('          : val,')
  console.log('      )')
  console.log('    }')
  console.log('')
  console.log('  白話解釋這段:它就是 JSON.stringify,但塞了一個 replacer。')
  console.log('  replacer 遇到「單純物件」時,先把 key 用 sort() 排好再重組一個新物件,')
  console.log('  所以 { a, b } 與 { b, a } 會被序列化成同一個字串。')

  if (!QC) {
    console.log('\n  (沒有安裝 @tanstack/query-core,實測部分跳過)')
    return
  }

  const { hashKey } = QC

  小標('實測一:物件 key 的順序不影響 key(這是好事)')
  const k1 = ['stats', { status: 'done', page: 1 }]
  const k2 = ['stats', { page: 1, status: 'done' }]
  console.log(`  hashKey(['stats', { status, page }]) = ${hashKey(k1)}`)
  console.log(`  hashKey(['stats', { page, status }]) = ${hashKey(k2)}`)
  console.log(`  相同嗎:${是否(hashKey(k1) === hashKey(k2))}`)
  console.log('  → 所以你不用擔心物件屬性寫的順序,這一點它幫你處理好了')

  小標('實測二:陷阱一 —— 數字 1 與字串 "1" 是不同的 key')
  console.log(`  hashKey(['stats', 1])   = ${hashKey(['stats', 1])}`)
  console.log(`  hashKey(['stats', '1']) = ${hashKey(['stats', '1'])}`)
  console.log(`  相同嗎:${是否(hashKey(['stats', 1]) === hashKey(['stats', '1']))}`)
  console.log('')
  console.log('  這一條最容易踩:網址參數(useParams、query string)拿到的永遠是字串,')
  console.log('  但你自己寫死的測試資料常常是數字。同一筆資料會被存成兩份快取,')
  console.log('  invalidate 其中一個,另一個不會動。')

  小標('實測三:陷阱二 —— 值是 undefined 的欄位會整個消失')
  const 有undefined = ['stats', { eventStatus: undefined, page: 1 }]
  const 沒那個欄位 = ['stats', { page: 1 }]
  console.log(`  hashKey(['stats', { eventStatus: undefined, page: 1 }]) = ${hashKey(有undefined)}`)
  console.log(`  hashKey(['stats', { page: 1 }])                        = ${hashKey(沒那個欄位)}`)
  console.log(`  相同嗎:${是否(hashKey(有undefined) === hashKey(沒那個欄位))}`)
  console.log('')
  console.log('  原因是 JSON.stringify 會丟掉值為 undefined 的屬性。')
  console.log('  所以「篩選器清空」與「根本沒有篩選器」會落在同一個快取格子裡。')
  console.log('  這通常剛好是你想要的,但它是巧合不是設計 —— 如果你希望兩者不同,')
  console.log('  要自己把它寫成 null 或字串。')

  小標('實測四:Date 會被序列化成 ISO 字串')
  console.log(`  hashKey(['stats', new Date('2026-09-27T00:00:00Z')]) = ${hashKey(['stats', new Date('2026-09-27T00:00:00Z')])}`)
  console.log('  → 同一個時間點的兩個 Date 物件會得到同一個 key,這也是好事')
  console.log('  → 但如果 key 裡放的是 new Date()(現在),每次 render 都是新 key,快取永遠不命中')
}

// ============================================================
// Part B:invalidateQueries 的前綴比對
// ============================================================

function partB() {
  分隔線('Part B:invalidateQueries 的前綴比對規則(partialMatchKey)')

  if (!QC) {
    console.log('  (沒有安裝 @tanstack/query-core,這一段跳過)')
    return
  }
  const { partialMatchKey } = QC

  console.log('  Day 25 的「模式三:分層 key 設計」靠的就是這個函式。')
  console.log('  它的規則是:把你傳給 invalidateQueries 的 key 當成**樣板**,')
  console.log('  逐項比對快取裡那把 key 的開頭。樣板比較短沒關係,樣板比較長就不算命中。')
  console.log('')

  const 案例 = [
    [['stats', 'list', { page: 1 }], ['stats'], '用 ["stats"] 失效整個 stats 家族'],
    [['stats', 'list', { page: 1 }], ['stats', 'list'], '用 ["stats","list"] 只失效列表'],
    [['stats'], ['stats', 'list'], '樣板比快取的 key 更長'],
    [['stats', { page: 1, q: 2 }], ['stats', { page: 1 }], '物件只比對樣板列出的欄位'],
    [['stats', { page: 1 }], ['stats', { page: 2 }], '欄位值不同'],
  ]

  console.log('| 快取裡的 queryKey | 傳給 invalidateQueries 的 key | 命中 | 說明 |')
  console.log('|---|---|---|---|')
  for (const [快取key, 樣板, 說明] of 案例) {
    const 命中 = partialMatchKey(快取key, 樣板)
    console.log(`| \`${JSON.stringify(快取key)}\` | \`${JSON.stringify(樣板)}\` | ${是否(命中)} | ${說明} |`)
  }

  console.log('')
  console.log('  注意第四列:物件是「部分比對」,樣板沒寫到的欄位不會被檢查。')
  console.log('  所以 ["stats", { page: 1 }] 會一併失效掉 page 是 1 但其他條件各異的所有快取。')
  console.log('  這個行為很方便,但也代表你很容易 invalidate 到比預期更多的東西。')
}

// ============================================================
// Part C:structural sharing 的本體
// ============================================================

function partC() {
  分隔線('Part C:structural sharing 的本體是 replaceEqualDeep')

  console.log('  官方文件對 structural sharing 只有一句話:')
  console.log('    「React Query will keep the original reference if nothing changed in the data.」')
  console.log('    「If a subset changed, React Query will keep the unchanged parts')
  console.log('      and only replace the changed parts.」')
  console.log('')
  console.log('  那句話的實作就是 replaceEqualDeep。它最後一行是整段的靈魂:')
  console.log('')
  console.log('    return aSize === bSize && equalItems === aSize ? a : copy')
  console.log('')
  console.log('  白話解釋這行:如果新舊資料的欄位數一樣,而且每一個欄位都判定相等,')
  console.log('  就**回傳舊的那個 a**,新拿到的 b 直接丟掉。否則回傳一個新物件 copy,')
  console.log('  但 copy 裡面沒變的那些子物件,仍然塞的是 a 的子物件(同一個參考)。')

  if (!QC) {
    console.log('\n  (沒有安裝 @tanstack/query-core,實測部分跳過)')
    return
  }
  const { replaceEqualDeep } = QC

  小標('實測一:內容完全相同 → 回傳的就是舊物件本身')
  const 舊 = { sold: 120, list: [{ id: 1, n: 'a' }, { id: 2, n: 'b' }], meta: { page: 1 } }
  const 新 = JSON.parse(JSON.stringify(舊))     // 模擬 refetch 回來一份內容相同的新資料
  console.log(`  舊 === 新(兩個不同的物件):${是否(舊 === 新)}`)
  const 結果 = replaceEqualDeep(舊, 新)
  console.log(`  replaceEqualDeep(舊, 新) === 舊:${是否(結果 === 舊)}   ← 這就是「保住參考」`)
  console.log(`  replaceEqualDeep(舊, 新) === 新:${是否(結果 === 新)}   ← 新的那份被丟掉了`)
  console.log('')
  console.log('  這一行為什麼重要:React 判斷要不要重繪用的是 Object.is 比參考(Day 23 講過)。')
  console.log('  參考沒變,React 就有機會跳過。所以「後端回來一樣的資料」在 TanStack Query 裡')
  console.log('  是真的不會造成新參考,不是靠你自己寫 useMemo 去救。')

  小標('實測二:只改一個欄位 → 沒改的子物件仍然共用')
  const 改了sold = { ...新, sold: 45 }
  const 結果2 = replaceEqualDeep(舊, 改了sold)
  console.log(`  整體同參考:${是否(結果2 === 舊)}   ← 因為 sold 真的變了,所以外層必須換新`)
  console.log(`  結果2.list === 舊.list:${是否(結果2.list === 舊.list)}   ← 沒改的部分重用`)
  console.log(`  結果2.meta === 舊.meta:${是否(結果2.meta === 舊.meta)}   ← 沒改的部分重用`)
  console.log(`  結果2.sold = ${結果2.sold}`)
  console.log('')
  console.log('  所以掛在 list 上面的那個 useMemo(例如排序、分組)**不會**因為 sold 變了而重算。')
  console.log('  這是 structural sharing 真正幫你省下來的東西。')
}

// ============================================================
// Part D:哪些型別會讓它破功
// ============================================================

function partD() {
  分隔線('Part D:哪些資料型別會讓 structural sharing 整包破功')

  console.log('  replaceEqualDeep 裡有一行守門員:')
  console.log('')
  console.log('    const array = isPlainArray(a) && isPlainArray(b)')
  console.log('    if (!array && !(isPlainObject(a) && isPlainObject(b))) return b')
  console.log('')
  console.log('  白話解釋這行:只有「單純陣列」與「單純物件」會進去逐欄位比對,')
  console.log('  其他東西一律 return b —— 直接換成新的那份,不做任何重用。')
  console.log('  這就是官方說的「只適用於 JSON 相容的資料」在原始碼裡的樣子。')

  if (!QC) {
    console.log('\n  (沒有安裝 @tanstack/query-core,實測部分跳過)')
    return
  }
  const { replaceEqualDeep } = QC

  小標('實測一:六種型別,內容都一樣,誰能重用舊參考')
  const 案例 = [
    ['單純物件', () => ({ n: 'a' })],
    ['單純陣列', () => [1, 2, 3]],
    ['Map', () => new Map([['a', 1]])],
    ['Set', () => new Set([1, 2])],
    ['Date', () => new Date('2026-01-01')],
    ['class 實例', () => { class P { constructor() { this.n = 'a' } } return new P() }],
  ]
  console.log('')
  console.log('| 型別 | 內容相同時能重用舊參考嗎 |')
  console.log('|---|---|')
  for (const [名稱, 造一個] of 案例) {
    const a = 造一個(); const b = 造一個()
    console.log(`| ${名稱} | ${是否(replaceEqualDeep(a, b) === a)} |`)
  }

  小標('實測二:最現實的那個雷 —— 外層是單純物件,但有一個 Date 欄位')
  const a = { sold: 1, updatedAt: new Date('2026-01-01') }
  const b = { sold: 1, updatedAt: new Date('2026-01-01') }
  const r = replaceEqualDeep(a, b)
  console.log(`  整體重用:${是否(r === a)}`)
  console.log(`  updatedAt 重用:${是否(r.updatedAt === a.updatedAt)}`)
  console.log('')
  console.log('  一個欄位破功,整包就跟著破功。理由回到 Part C 那一行:')
  console.log('  equalItems 少算一個,equalItems === aSize 不成立,所以回傳 copy 而不是 a。')
  console.log('')
  console.log('  什麼時候會發生:後端回傳的 JSON 裡 updatedAt 是**字串**,所以原本沒事。')
  console.log('  但只要你在 select 裡寫 new Date(row.updatedAt) 把它轉成 Date 物件,')
  console.log('  structural sharing 就從那一刻開始對這包資料完全失效。')
  console.log('  同理:在 select 裡 new Map(...)、包成 class 實例、或用 Immutable.js 的結構。')
}

// ============================================================
// Part E:參考穩了不等於不重繪
// ============================================================

async function partE() {
  分隔線('Part E:參考穩了不等於不重繪 —— 用真實 QueryObserver 量通知次數')

  if (!QC) {
    console.log('  (沒有安裝 @tanstack/query-core,這一段跳過)')
    return
  }
  const { QueryClient, QueryObserver, notifyManager } = QC

  // 讓通知同步送達,方便計數。真實 React 環境是批次非同步的
  notifyManager.setScheduler((cb) => cb())

  console.log('  劇本:同一個 query 連續 refetch 四次,後端每次都回**完全相同**的資料。')
  console.log('  理想狀況下畫面一次都不該更新。實際有幾次通知?')

  /** 每次都建立乾淨的 client,避免互相影響 */
  async function 量一次(標籤, options, 讀取方式) {
    const client = new QueryClient({ defaultOptions: { queries: { retry: false, gcTime: Infinity } } })
    let 通知次數 = 0
    const observer = new QueryObserver(client, {
      queryKey: ['stats'],
      queryFn: async () => ({ sold: 120, list: [{ id: 1, n: 'a' }, { id: 2, n: 'b' }] }),
      ...options,
    })
    const 取消訂閱 = observer.subscribe((result) => {
      通知次數 += 1
      if (讀取方式) 讀取方式(observer.trackResult(result))
    })
    for (let i = 0; i < 4; i += 1) await observer.refetch()
    取消訂閱()
    client.clear()
    return 通知次數
  }

  小標('組一:模擬 React 的 tracked properties(元件讀了什麼就訂閱什麼)')
  console.log('  trackResult 會把結果包成 Proxy,你讀哪個屬性就訂閱哪個屬性。')
  console.log('  這是 React adapter 預設幫你做的事,官方文件叫 tracked properties。')
  console.log('')
  const 只讀data = await 量一次('只讀 data', {}, (r) => { const _ = r.data })
  const 讀data與isFetching = await 量一次('讀 data 與 isFetching', {}, (r) => { const _ = r.data; const __ = r.isFetching })
  const 用rest解構 = await 量一次('用 {...rest} 解構', {}, (r) => { const { ...rest } = r })

  console.log('| 元件怎麼用 useQuery 的回傳值 | 四次 refetch 的通知次數 |')
  console.log('|---|---|')
  console.log(`| \`const { data } = useQuery(...)\` | ${只讀data} |`)
  console.log(`| \`const { data, isFetching } = useQuery(...)\` | ${讀data與isFetching} |`)
  console.log(`| \`const { ...rest } = useQuery(...)\` | ${用rest解構} |`)
  console.log('')
  console.log(`  只讀 data 是 ${只讀data} 次(初次 pending 與初次拿到資料),之後完全安靜,`)
  console.log('  因為 data 的參考被 replaceEqualDeep 保住了,Proxy 判定「你在意的東西沒變」。')
  console.log(`  一旦你多讀了 isFetching,就變成 ${讀data與isFetching} 次 —— 每次 refetch 的開始與結束各一次。`)
  console.log('  官方文件對第三列有明確警告:')
  console.log('    「If you use object rest destructuring, you will disable this optimization.」')
  console.log('  因為 rest 解構會把每一個屬性都讀一遍,等於訂閱了全部。')

  小標('組二:把幾個開關關掉,看它們各自值多少')
  const 預設無追蹤 = await 量一次('預設、不追蹤', {}, null)
  const 只通知data = await 量一次('notifyOnChangeProps: ["data"]', { notifyOnChangeProps: ['data'] }, null)
  const 全部通知 = await 量一次("notifyOnChangeProps: 'all'", { notifyOnChangeProps: 'all' }, null)
  const 關掉結構共用 = await 量一次('structuralSharing: false', { structuralSharing: false }, null)
  const select產生新陣列 = await 量一次('select 每次產生新陣列', { select: (d) => d.list.map((x) => ({ ...x })) }, null)

  console.log('')
  console.log('| 設定 | 四次 refetch 的通知次數 |')
  console.log('|---|---|')
  console.log(`| 什麼都不設(沒有 Proxy 追蹤) | ${預設無追蹤} |`)
  console.log(`| \`notifyOnChangeProps: ['data']\` | ${只通知data} |`)
  console.log(`| \`notifyOnChangeProps: 'all'\` | ${全部通知} |`)
  console.log(`| \`structuralSharing: false\` | ${關掉結構共用} |`)
  console.log(`| \`select: d => d.list.map(...)\` | ${select產生新陣列} |`)

  console.log('')
  console.log('  要老實講一件事,不然這張表會被誤讀:')
  console.log('')
  console.log('    這裡量的是 **observer 的通知次數**,不是 React 的 render 次數。')
  console.log('    純 query-core 沒有 React adapter,所以沒有自動的 Proxy 追蹤,')
  console.log(`    預設就是「什麼都通知」(${預設無追蹤} 次)。`)
  console.log('    在 React 裡你不用手寫 notifyOnChangeProps,因為 adapter 用 Proxy 幫你推斷;')
  console.log('    組一的 trackResult 就是我用來重現那個推斷的。')
  console.log('')
  console.log('  真正的結論是這兩句:')
  console.log('    a. structural sharing 保住的是 **data 的參考**,它不負責「不通知」')
  console.log('    b. 決定要不要重繪的是 **你在元件裡讀了哪些屬性**')
  console.log('  兩件事都做對才會安靜。只做對一件,畫面照樣每次 refetch 閃兩下。')
}

// ============================================================
// Part F:useMemo 的命中率由上游決定
// ============================================================

function partF() {
  分隔線('Part F:useMemo 的命中率由上游決定,不是由你決定')

  console.log('  React 官方文件對 useMemo 有兩句話值得先擺出來:')
  console.log('    「React will compare each dependency with its previous value')
  console.log('      using the Object.is comparison.」')
  console.log('    「You should only rely on useMemo as a performance optimization.')
  console.log('      If your code doesn\'t work without it, find the underlying problem')
  console.log('      and fix it first.」')
  console.log('')
  console.log('  把這兩句話跟 Part C 接起來就是今天的主結論:')
  console.log('  useMemo 的依賴比較用的是 Object.is 比參考,而那個參考穩不穩,')
  console.log('  是 **上游**(TanStack Query 的 structural sharing、或你的 select)決定的。')

  /** 手寫一個最小的 useMemo:只有依賴陣列與 Object.is 比較 */
  function createMemo() {
    let 上次依賴 = null
    let 上次結果
    let 命中 = 0
    let 未命中 = 0
    return {
      run(計算, 依賴) {
        if (
          上次依賴 !== null &&
          上次依賴.length === 依賴.length &&
          依賴.every((d, i) => Object.is(d, 上次依賴[i]))
        ) {
          命中 += 1
          return 上次結果
        }
        未命中 += 1
        上次依賴 = 依賴
        上次結果 = 計算()
        return 上次結果
      },
      get 命中() { return 命中 },
      get 未命中() { return 未命中 },
    }
  }

  /** 一個真的有點成本的衍生計算:排序 + 分組 + 加總 */
  function 衍生計算(list) {
    const sorted = [...list].sort((a, b) => a.amount - b.amount)
    const groups = new Map()
    for (const row of sorted) {
      const g = groups.get(row.status) || { count: 0, sum: 0 }
      g.count += 1
      g.sum += row.amount
      groups.set(row.status, g)
    }
    return groups
  }

  const 造資料 = (n) =>
    Array.from({ length: n }, (_, i) => ({
      id: i,
      status: ['done', 'pending', 'cancelled'][i % 3],
      amount: (i * 7919) % 1000,
    }))

  小標('實測一:上游參考穩不穩,決定 useMemo 是最佳化還是純成本')

  const N = 2000
  const 渲染次數 = 300
  const 資料 = 造資料(N)

  // 情況一:上游參考穩定(structural sharing 生效)
  const memo穩定 = createMemo()
  const t1 = process.hrtime.bigint()
  for (let i = 0; i < 渲染次數; i += 1) memo穩定.run(() => 衍生計算(資料), [資料])
  const t2 = process.hrtime.bigint()

  // 情況二:上游每次都是新參考(structuralSharing: false,或 select 產生新陣列)
  const memo不穩 = createMemo()
  const t3 = process.hrtime.bigint()
  for (let i = 0; i < 渲染次數; i += 1) {
    const 每次都新的 = 資料.map((x) => x)        // 內容一樣,參考是新的
    memo不穩.run(() => 衍生計算(每次都新的), [每次都新的])
  }
  const t4 = process.hrtime.bigint()

  // 情況三:完全不用 useMemo
  const t5 = process.hrtime.bigint()
  for (let i = 0; i < 渲染次數; i += 1) 衍生計算(資料)
  const t6 = process.hrtime.bigint()

  const ms = (a, b) => Number(b - a) / 1e6

  console.log('')
  console.log(`  資料 ${N} 筆,模擬 ${渲染次數} 次 render`)
  console.log('')
  console.log('| 情況 | 總耗時(毫秒) | memo 命中 | memo 未命中 |')
  console.log('|---|---|---|---|')
  console.log(`| a. 上游參考穩定 + useMemo | ${ms(t1, t2).toFixed(1)} | ${memo穩定.命中} | ${memo穩定.未命中} |`)
  console.log(`| b. 上游每次新參考 + useMemo | ${ms(t3, t4).toFixed(1)} | ${memo不穩.命中} | ${memo不穩.未命中} |`)
  console.log(`| c. 完全不用 useMemo | ${ms(t5, t6).toFixed(1)} | — | — |`)
  console.log('')
  console.log(`  b 比 c 還慢(${ms(t3, t4).toFixed(1)} 對 ${ms(t5, t6).toFixed(1)} 毫秒),因為它每次都重算,`)
  console.log('  外加一次依賴比較與一次 map 複製。**這就是「最佳化反而把事情搞更複雜」的量化版本。**')
  console.log('')
  console.log('  請注意 b 的成因不在 useMemo 那一行,而在上游給了新參考。')
  console.log('  在真實專案裡,上游就是 `structuralSharing: false`、或 select 每次 map 出新陣列、')
  console.log('  或你在 select 裡把字串轉成 Date(Part D 那個雷)。')

  小標('實測二:資料量多少才值得 memo')
  console.log('  固定上游參考穩定,只改資料量,看 useMemo 省下多少')
  console.log('')
  console.log('| 資料筆數 | 不用 memo(毫秒) | 用 memo 且命中(毫秒) | 省下 | 每次 render 省 |')
  console.log('|---|---|---|---|---|')
  for (const n of [1, 10, 100, 1000, 10000]) {
    const d = 造資料(n)
    const m = createMemo()
    // 暖機
    for (let i = 0; i < 20; i += 1) { 衍生計算(d); m.run(() => 衍生計算(d), [d]) }

    const a1 = process.hrtime.bigint()
    for (let i = 0; i < 渲染次數; i += 1) 衍生計算(d)
    const a2 = process.hrtime.bigint()

    const m2 = createMemo()
    const b1 = process.hrtime.bigint()
    for (let i = 0; i < 渲染次數; i += 1) m2.run(() => 衍生計算(d), [d])
    const b2 = process.hrtime.bigint()

    const 不用 = ms(a1, a2); const 用 = ms(b1, b2)
    const 省 = 不用 - 用
    console.log(
      `| ${n} | ${不用.toFixed(2)} | ${用.toFixed(2)} | ${省.toFixed(2)} 毫秒 | ${((省 / 渲染次數) * 1000).toFixed(1)} 微秒 |`,
    )
  }
  console.log('')
  console.log('  這張表的讀法:看最後一欄。')
  console.log('  如果「每次 render 省下的時間」遠小於一格畫面的預算(60fps 是 16.7 毫秒),')
  console.log('  那這個 useMemo 對使用者是沒有感覺的,你只是多維護了一個依賴陣列。')
  console.log('  資料量小的時候甚至可能是負的 —— 比較依賴本身也要錢。')
}

// ============================================================
// main
// ============================================================

async function main() {
  console.log('day26-structural-sharing-and-memo.js')
  console.log(`Node ${process.version}|執行時間 ${new Date().toISOString()}`)
  console.log(`@tanstack/query-core ${QC版本}`)

  partA()
  partB()
  partC()
  partD()
  await partE()
  partF()

  分隔線('六句話總結')
  console.log('  1. queryKey 是用 JSON.stringify 比較的,而且物件 key 會先排序(hashKey)')
  console.log('  2. 兩個陷阱:數字 1 與字串 "1" 不同;值為 undefined 的欄位會整個消失')
  console.log('  3. structural sharing 的本體是 replaceEqualDeep:內容沒變就回傳**原本那個物件**')
  console.log('  4. 只有單純物件與單純陣列適用。一個 Date 欄位就讓整包破功')
  console.log('  5. 參考穩了不等於不重繪。決定重繪的是你在元件裡讀了哪些屬性')
  console.log('  6. useMemo 的命中率由上游決定。上游穩了很多 useMemo 不必寫,上游不穩 useMemo 也救不了')
}

main().catch((error) => {
  console.error('執行失敗:', error)
  process.exit(1)
})
一、官方文件與原始碼(可查證的一手來源)
| 內容 | 出處 |
|---|---|
structural sharing 的兩句定義:「will keep the original reference if nothing changed in the data」、「keep the unchanged parts and only replace the changed parts」,以及「只適用於 JSON 相容資料」、可用 structuralSharing: false 關掉 |
TanStack Query 官方文件,Render Optimizations:https://tanstack.com/query/latest/docs/framework/react/guides/render-optimizations |
tracked properties 用 Proxy 實作、「will only trigger a re-render if one of the properties returned from useQuery is actually 'used'」、以及「If you use object rest destructuring, you will disable this optimization」 |
同上,tracked properties 章節 |
select 的 memoization 規則:只在「select 函式本身參考變了」或「data 變了」時重跑 |
同上,select 章節 |
hashKey、partialMatchKey、replaceEqualDeep 的完整原始碼 |
packages/query-core/src/utils.ts:https://github.com/TanStack/query/blob/main/packages/query-core/src/utils.ts |
useMemo 的依賴用 Object.is 比較 |
React 官方文件:https://react.dev/reference/react/useMemo |
「You should only rely on useMemo as a performance optimization. If your code doesn't work without it, find the underlying problem and fix it first.」 |
同上 |
| React 不保證會保留快取值:「React will not throw away the cached value unless there is a specific reason to do that.」 | 同上 |
Object.is 的比較語意 |
MDN:https://developer.mozilla.org/en-US/docs/Web/JavaScript/Reference/Global_Objects/Object/is |
JSON.stringify 會忽略值為 undefined 的物件屬性、Date 會被轉成 ISO 字串 |
MDN:https://developer.mozilla.org/en-US/docs/Web/JavaScript/Reference/Global_Objects/JSON/stringify |
二、我實際跑出來的部分
Part A 到 Part F 的所有輸出,由 day26-structural-sharing-and-memo.js 實測產生(Node.js v22.22.2、@tanstack/query-core 5.104.0,2026-09-27 執行),可以重跑驗證。其中:
hashKey、partialMatchKey、replaceEqualDeep 是 query-core 公開匯出的真實函式,不是我照抄的複製品QueryClient 與 QueryObserver,通知次數是真的訂閱回呼被呼叫的次數createMemo 是我手寫的最小模型(只有依賴陣列與 Object.is 比較),不是 React 的 useMemo
三、我自己的整理與判斷(沒有外部出處)
Date 欄位就讓整包破功」這個推論,是我從 equalItems === aSize 那一行推出來的,然後用 Part D 實測二驗證useMemo 的命中率由上游決定」這個主結論,以及「你去調 useMemo 永遠調不好,因為問題在上面」這個說法四、我沒有驗證的部分
main 分支,不是 5.104.0 的 tag。 實測跑的是 npm 安裝的 5.104.0,行為與我讀的原始碼一致,但我沒有逐行確認那個版本的檔案內容與 main 完全相同。如果之後版本有變,請以你裝的那版為準observer.trackResult() 重現的,trackResult 確實是 query-core 上的公開方法,但 React 的 useBaseQuery 是否只做這件事、有沒有額外邏輯,我沒有確認select 的 memoization 我只讀了文件,沒有實測。 文件說它只在「select 函式參考變了」或「data 變了」時重跑,我沒有寫測試去確認邊界structuralSharing 的預設值是 true,這是文件語意(它說「可以用 structuralSharing: false 關掉」)加上 Part C 實測行為的推論。我沒有在文件上找到一張明寫 default 的選項表
select 裡轉 Date」,但我沒有實測「轉在元件裡」的成本。理論上那會變成每次 render 都轉一次,對大列表可能反而更貴——這個取捨我沒有量
五、幾個要講清楚的量測限制
useMemo 更早變得值得。所以不要把「一萬筆」當成通用門檻
notifyManager 的 scheduler 改成同步(setScheduler(cb => cb()))才方便計數。真實環境是批次非同步的,所以通知的時機與我印出來的不同,但次數的相對關係成立資料.map(x => x) 製造新參考。這比真實的 structuralSharing: false 多付了一次淺複製的成本,所以 94.1 這個數字偏高。要證明的是「b > c」這個方向,不是那個差距的精確大小(查閱日期:2026-09-27。程式碼實測於 Node.js v22.22.2、@tanstack/query-core 5.104.0)
hashKey 的問號,並補上兩個因為「序列化比較」才會出現的陷阱。Day 25 講怎麼設計 key,今天講它怎麼比 key
Object.is 比參考」正是今天所有討論的起點;二是 tracked properties 用 Proxy 做的,那正好是 Day 23 那張表裡的「攔截」,只是攔的不是 state,是 useQuery 的回傳值{ ...cache, ...patch },每次都造新物件;今天講的 replaceEqualDeep 是反方向——盡量不造新物件。兩篇合起來才是完整的「什麼時候該給新參考、什麼時候該保住舊參考」frontend-docs/tanstack/ 整包:關聯原因:onMutate-optimistic-update.md、invalidate-list-vs-single.md、context.previous.md 都在講「快取怎麼寫」,今天補的是「快取寫進去之後,誰決定畫面要不要動」今天講的是「同一筆資料回來,怎麼讓 React 別動」。
明天 Day 27 反過來:當資料真的變了,React 要怎麼決定哪幾個 DOM 節點該動——列表的 key 為什麼不能用陣列索引,以及 Day 23 提到的 Fiber 雙緩衝在這一步實際做了什麼。那個「刪掉第一筆,結果整個列表的 input 內容全部錯位」的經典 bug,就是這一步出錯的樣子。


 iThome鐵人賽
 看影片追技術